AI 治理
從 9.7 到 3.2:金融代理 RAG 的風險量化之路
以 AIDEFEND 與 AITBM 的金融服務代理 RAG 實例,拆解 12 道防禦控制如何將臨界風險系統拉回可接受區間
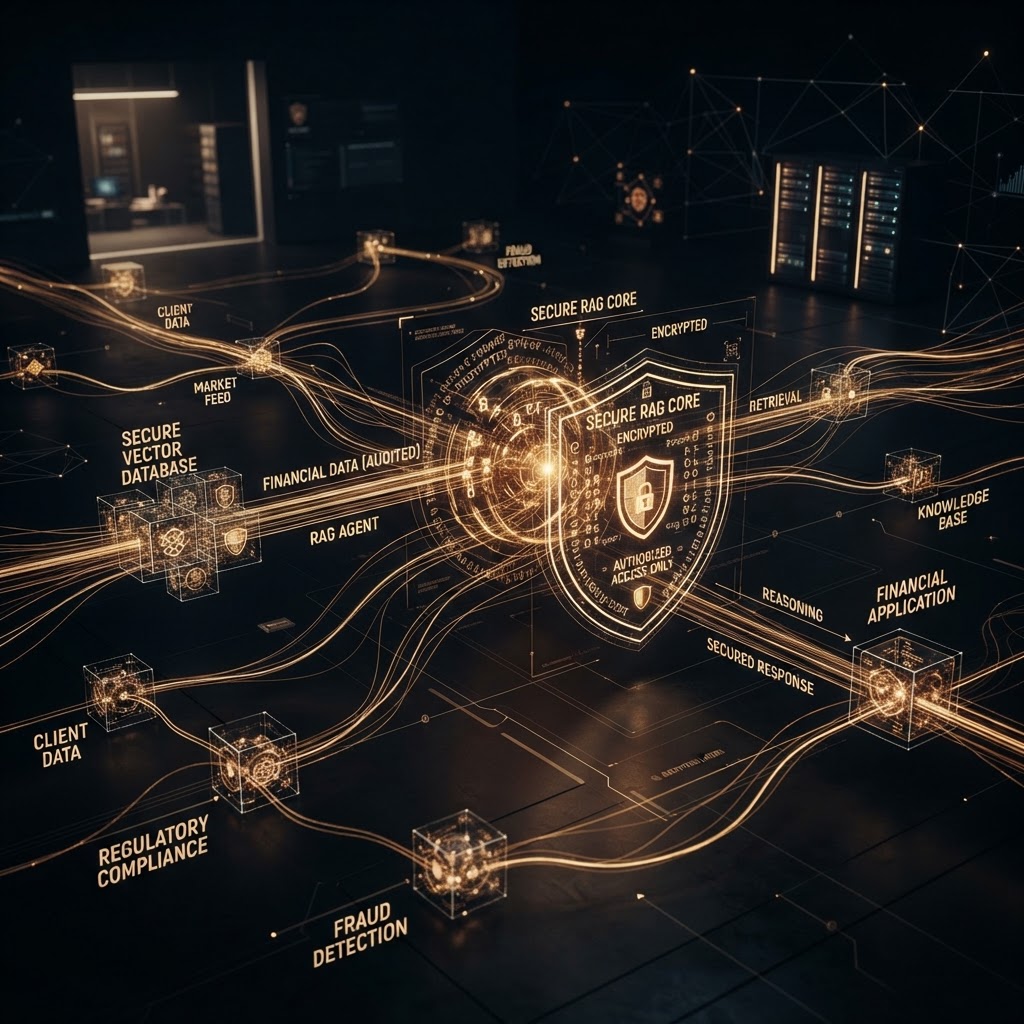
當金融服務擁抱代理式 RAG(Agentic RAG),第一個被問到的問題永遠是:「它安全嗎?」
但「安全嗎」其實是一個無法回答的問題——因為它缺乏可量化的評估框架。2026 年 AITBM.org 在 AIDEFEND 防禦框架的對應頁面中,提供了一個極具參考價值的實作範例(worked example):一個對外開放、Tier I 層級、具備 L3 條件自主(conditional autonomy)的金融顧問代理,結合 RAG 檢索增強生成能力。在給定的有效性與證據假設下,十二道對應的 AIDEFEND 防禦控制,將系統的有效風險得分(Effective Risk Score, ERS)從 9.7(臨界,不可接受) 降至 3.2(低-中度,可接受)。
這個範例的價值不在於具體數字,而在於它揭示了 AI 安全治理從「控制清單」走向「量化評估」的方法論。
個案設定:一個會自己行動的金融顧問
這個範例的標的系統具備以下特徵:
- 對外開放:部署於網際網路,供客戶直接互動。
- Tier I 金融顧問代理:提供金融諮詢建議,直接觸及客戶資產與敏感資料。
- RAG 增強:透過檢索增強生成,從內部知識庫與客戶資料中取得上下文。
- L3 條件自主:在特定條件下,代理可在無人工介入下自主完成部分操作。
這正是當前金融機構在數位轉型中最渴望、也最忌憚的場景:代理具備存取敏感客戶資料、執行金融操作建議,且擁有部分自主權。一旦失控,財務衝擊半徑(financial blast radius)極大。
風險三層結構:為什麼 9.7 變成 3.2
AITBM 將風險拆解為三層,每一層都有獨立的評估邏輯,最終由 ERS 公式整合:
一、內在安全(Intrinsic Vulnerability Profile, IVP):0.32 → 0.68
基線階段,代理模型本身缺乏對抗提示注入的韌性,RAG 檢索的上下文易遭污染,且缺乏輸出過濾與洩漏偵測。四道控制改變了這一層:
- 對抗性強化訓練(AID-H-001)與輸入淨化驗證(AID-H-002):讓模型在面對提示注入時保持穩健(Ro-1)。
- 安全 RAG 實作(AID-H-020):針對被污染的檢索上下文建立防護(Ro-4)。
- 輸出內容過濾(AID-H-006)與敏感資料洩漏偵測(AID-D-003):阻止代理洩漏其檢索到的客戶資料(Cn-3、Pr-1)。
這層的核心訊息是:模型不再盲目服從注入指令,也不再洩漏它所讀到的內容。
二、部署風險(Contextual Risk Multiplier, CRM):1.60 → 1.00
基線階段,系統同時具備四個風險放大維度——對外暴露、L3 自主、金融衝擊半徑、修復困難——複合放大倍率達 1.60 倍。三道控制改變了這一層:
- 代理權限限制(AID-H-018):限制代理可執行的操作邊界(Cn-1、Cn-2)。
- 代理自主治理(AID-M-009):建立自主決策的治理框架。
- 人工介入控制設計(AID-M-006):在關鍵節點設置人工審核(HITL)。
- 加密代理身分(Cn-5):確保「誰在行動」可被證明。
當代理的行動邊界被約束、身分可歸因,足夠多的維度降至風險放大閾值之下,倍率便退回 1.00——不再放大。
三、保證信心(Assurance Confidence Index, ACI):0.40 → 0.90
基線階段,Tier I 系統僅仰賴一次性評估,信心衰減極快,低信心反而放大了風險得分。兩道控制改變了這一層:
- 代理行為監控(AID-D-011)與資料溯源追蹤(AID-M-002):以持續、可歸因的證據取代一次性快照(Cn-5、Tr-4)。
- 行為基準偏離偵測:即時標記代理行為的漂移。
這層的核心訊息是:持續監控取代了定期評估,信心指數不再折損評估結果。
關鍵洞察:代理控制才是風險削減的主力
在 AIDEFEND 的「十大高衝擊控制」排名中,六項聚焦代理(agentic)的控制貢獻了總風險削減能力的 55%。排名第一的代理權限限制(AID-H-018)與第二的代理自主治理(AID-M-009)分別帶來 5.8 與 5.4 的 ERS 削減,遠高於傳統的對抗性訓練或輸入淨化。
這揭示了一個對金融機構至關重要的趨勢:在代理式 AI 場景中,治理控制(誰能做什麼、做到什麼程度、由誰證明)的防禦價值,已超越單純的技術防護。 傳統資安將重心放在模型本身的對抗韌性與輸入淨化,但在具備自主權與工具呼叫能力的代理系統中,真正的風險熱點已轉移到「過度授權」(excessive agency)與「身分不可歸因」。
對台灣金融機構的實務啟示
台灣金融機構正積極探索 AI 代理在財富管理、智能客服、風險評估等場景的應用。結合 AIDEFEND 實作範例與博曄顧問的實務經驗,我提出三點建議:
一、風險量化應先於功能部署
許多金融機構在代理功能開發完成後才補上資安評估,導致風險發現時已難以回頭。應在設計階段導入 AITBM 般的多維量化框架,以 IVP、CRM、ACI 三層結構預先識別風險熱點,並將防禦控制設計納入開發生命週期,而非事後追加。
二、代理治理應成為 AI 風險管理的核心
代理權限限制、自主治理、人工介入控制這三項控制的合計 ERS 削減超過 15 分,是傳統模型防護的數倍。金融機構應將「代理能做什麼、做到什麼程度、何時必須停下來等人類」寫入治理制度,並透過合約、稽核與技術控制三重確保落實。
三、持續保證取代定期評估
金融監理長期依賴定期稽核,但 Tier I 代理系統的風險態勢變化極快,一次性評估的信心衰減迅速。應建立代理行為監控、資料溯源與行為基準偏離偵測的持續保證機制,讓 ACI 維持在高水準,避免風險得分因信心不足而被放大。
結語:從「控制清單」走向「風險量化」
AIDEFEND 與 AITBM 的金融服務代理 RAG 實作範例,為 AI 安全治理提供了一個關鍵範式轉移:從逐一檢查控制是否存在,走向以證據為基礎的多維風險量化。 控制的價值不在於被部署,而在於其部署證據能滿足適用的評分準則,進而改變系統的風險態勢。
對金融機構而言,這意味著 AI 安全不再是「我們有沒有做防護」的二元問題,而是「我們的防護證據,能將風險降至何種可接受程度」的量化問題。當 9.7 能被拉回 3.2,代理式 AI 才真正具備在受監管金融場景中負責任落地的條件。
參考資料:
- AITBM, AIDEFEND Mapping — Worked Example: Financial Services Agentic RAG, 2026. aitbm.org/aidefend#worked-example
- AIDEFEND Knowledge Base. aidefend.net
- OWASP LLM Top 10 (2026).
- OWASP Top 10 for Agentic Applications (2026).